Amazonbot: cuando el robot de Amazon pone de rodillas a su servidor
En los servidores que administramos, Amazonbot aparece con regularidad en nuestros análisis de tráfico, junto a otros robots de IA como GPTBot o meta-externalagent. No se trata de una postura de principio contra la IA: lo hemos observado en varios episodios de carga en los que el robot de Amazon encabezaba los registros, en sitios a los que nunca les ha aportado nada.
Este artículo explica qué hace Amazonbot, por qué pesa tanto en las tiendas en línea, cómo detectarlo en sus registros y qué opciones tiene para frenarlo o bloquearlo.
¿Qué es exactamente Amazonbot?
Amazonbot es el rastreador web generalista de Amazon: según su página oficial, sirve para mejorar los productos y servicios de la empresa y puede utilizarse para entrenar sus modelos de IA. Presentado en su origen como el robot que alimenta a Alexa, hoy es claramente un recolector de datos de entrenamiento.
Amazon distingue ahora tres agentes, cada uno configurable por separado en el robots.txt:
| Agente | Función declarada | Entrenamiento de IA | Respeto del robots.txt |
|---|---|---|---|
| Amazonbot | Mejora de productos y servicios | Sí, posible | Sí |
| Amzn-SearchBot | Experiencias de búsqueda (Alexa, etc.) | No | Sí; a falta de una regla propia, sigue las dadas a los demás buscadores |
| Amzn-User | Recuperación en directo para responder a un usuario | No | No siempre, ya que la acción la inicia una persona |
El user-agent se parece a un Chrome corriente seguido de la mención compatible; Amazonbot/0.1. Amazon publica la lista de IP de cada agente, lo que permite distinguir el robot auténtico de un impostor.
Hay un detalle muy importante para un proveedor de alojamiento: Amazonbot no admite la directiva Crawl-delay. Es imposible, por tanto, pedirle simplemente que vaya más despacio. En cambio, respeta Disallow, rel=nofollow y las metaetiquetas noindex y noarchive; esta última significa para Amazon «no utilizar la página para el entrenamiento». Cualquier cambio en el robots.txt puede tardar unas 24 horas en aplicarse, y el robot puede basarse en una copia en caché de hasta 30 días.
Los problemas observados
El principal reproche a Amazonbot no es que exista, sino que llegue en oleadas, sin avisar y sin freno. No somos los únicos que lo hemos constatado.
| Quién | Cuándo | Qué ocurrió |
|---|---|---|
| Xe Iaso, desarrolladora | Enero de 2025 | Su servidor Git autoalojado se vuelve inestable bajo el tráfico atribuido a Amazon; acaba escribiendo Anubis, un filtro antirrobots por prueba de trabajo (Ars Technica) |
| git.gmem.ca | Junio de 2024 | Unas 25.000 peticiones de Amazonbot bloqueadas en menos de 24 horas en una pequeña forja Git |
| Hypernode, alojamiento de comercio electrónico | Mayo de 2023 | Varios servidores de tiendas en línea en los que más del 10 % de la potencia de cálculo se iba en Amazonbot; tráfico muy variable de una semana a otra |
| Foro de Discourse | 2021 | 39.649 peticiones de Amazonbot frente a 457 del siguiente visitante; una decena de IP de AWS enviando cada una más de 1.000 peticiones en el día; el autor acaba sospechando de un impostor |
Estos casos tienen algo en común: el robot se ceba en las páginas más costosas de generar. En una forja Git, son el historial de commits y las vistas blame. En una tienda WooCommerce o PrestaShop, son los filtros por facetas: cada combinación de color, talla, precio y marca genera una URL distinta, es decir, un número de páginas prácticamente infinito.
Un robot que sigue todos los enlaces sin límite de ritmo explora entonces miles de combinaciones que nadie consultará jamás. Cada una evita la caché de páginas, puesto que la URL es única, y desencadena una petición PHP y varias consultas SQL.
Un caso real: Amazonbot atrapado por la paginación de JetBlog
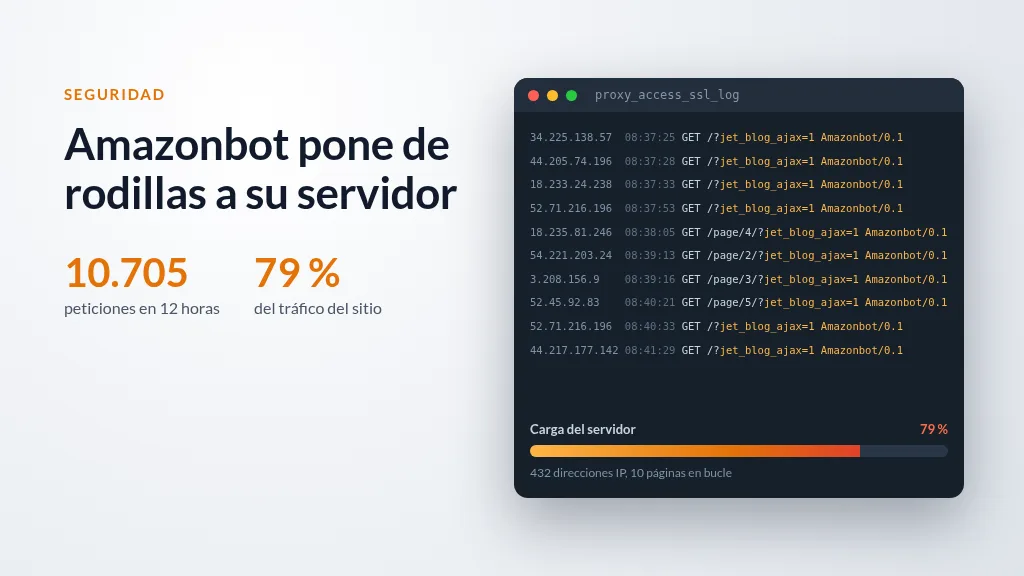
A principios de octubre de 2026, en un sitio WordPress que alojamos, Amazonbot se quedó dando vueltas en la paginación de un blog. En 12 horas, el 5 de octubre, envió 10.705 peticiones desde 432 direcciones IP, es decir, el 79 % de todo el tráfico del sitio. El tiovivo continuó al día siguiente; este es un extracto reducido del registro de accesos del 6 de octubre (el sitio no aparece y el user-agent está abreviado):
34.225.138.57  [06/Oct/2026:08:37:25] "GET /?jet_blog_ajax=1&nocache=1791224346&s"        200 32057 "-" "…Amazonbot/0.1…"
44.205.74.196  [06/Oct/2026:08:37:28] "GET /?jet_blog_ajax=1&nocache=1791228922&s"        200 32057 "-" "…Amazonbot/0.1…"
18.233.24.238  [06/Oct/2026:08:37:33] "GET /?jet_blog_ajax=1&nocache=1791120571&s"        200 32056 "-" "…Amazonbot/0.1…"
52.71.216.196  [06/Oct/2026:08:37:53] "GET /?jet_blog_ajax=1&nocache=1791224758&s"        200 32057 "-" "…Amazonbot/0.1…"
18.235.81.246  [06/Oct/2026:08:38:05] "GET /page/4/?jet_blog_ajax=1&nocache=1791241950&s" 200 31720 "-" "…Amazonbot/0.1…"
54.221.203.24  [06/Oct/2026:08:39:13] "GET /page/2/?jet_blog_ajax=1&nocache=1791241202&s" 200 31618 "-" "…Amazonbot/0.1…"
3.208.156.9    [06/Oct/2026:08:39:16] "GET /page/3/?jet_blog_ajax=1&nocache=1791240922&s" 200 31948 "-" "…Amazonbot/0.1…"
52.45.92.83    [06/Oct/2026:08:40:21] "GET /page/5/?jet_blog_ajax=1&nocache=1791241462&s" 200 30055 "-" "…Amazonbot/0.1…"
52.71.216.196  [06/Oct/2026:08:40:33] "GET /?jet_blog_ajax=1&nocache=1791213591&s"        200 32056 "-" "…Amazonbot/0.1…"
44.217.177.142 [06/Oct/2026:08:41:29] "GET /?jet_blog_ajax=1&nocache=1791126368&s" 200 32057 "-" "…Amazonbot/0.1…"Mozilla/5.0 AppleWebKit/537.36 (KHTML, like Gecko; compatible; Amazonbot/0.1; +https://developer.amazon.com/support/amazonbot) Chrome/119.0.6045.214 Safari/537.36| Medida (5 de octubre, de 8:00 a 20:00) | Valor |
|---|---|
| Peticiones de Amazonbot | 10.705, es decir, una cada 4 segundos de media |
| Parte del tráfico total del sitio | 79 % (10.705 peticiones de 13.611) |
| De ellas, paginación de JetBlog | 100 % |
| Regularidad | Entre 887 y 896 peticiones cada hora, 16 como máximo en un minuto |
| Direcciones IP distintas | 432; la más activa solo envió 52 peticiones en 12 horas |
| Páginas realmente diferentes | 10: la portada y las páginas 2 a 5 del blog, la página Referencias y sus páginas 2 a 4, una página de presentación |
| Respuestas | 100 % en HTTP 200 |
| Volumen servido | 323,6 MB, es decir, unos 30 KB por petición |
| Proyección a 24 horas a este ritmo | Unas 21.000 peticiones y 650 MB |
| IP comprobadas en la lista oficial de Amazonbot | 58 de 58 en el extracto del 6 de octubre (lista del 8 de septiembre de 2026) |
Lo que muestra este extracto
Es realmente Amazonbot, no un impostor. Todas las IP del extracto figuran en la lista publicada por Amazon. El robot oficial de una multinacional puede, por sí solo, producir este tipo de tráfico.
El robot cayó en una trampa de URL infinitas. El módulo de blog JetBlog (suite Crocoblock para Elementor) carga su paginación por AJAX. Sus enlaces llevan jet_blog_ajax=1 y un parámetro nocache distinto en cada visualización. Para un robot, cada valor es una página nueva: vuelve a pedir sin fin las mismas diez páginas con nombres distintos, con un ritmo de metrónomo. Los valores de nocache parecen además marcas de tiempo de los días anteriores, señal de que el robot reproduce enlaces recogidos en pasadas anteriores.
La caché no sirve de nada. Como cada URL es única, ninguna respuesta se sirve desde la caché: las 10.705 peticiones de las 12 horas fueron calculadas por PHP y MySQL, para devolver una y otra vez las mismas diez páginas.
Bloquear por IP es inútil. Con 432 direcciones en 12 horas, la IP más activa solo envió 52 peticiones, apenas algo más de 4 por hora. Un fail2ban o un límite de peticiones por IP no ve nada anormal; solo la firma de la petición, el user-agent o la forma de la URL, permite reaccionar.
Lo que hemos implantado
En lugar de bloquear Amazonbot, atacamos la causa: una regla en el cortafuegos de aplicaciones neutraliza esta trampa para todos los robots. Una paginación de JetBlog solicitada sin la cabecera AJAX X-Requested-With, algo que ningún navegador hace, se redirige con un 301 a la URL limpia. El robot vuelve así a una sola dirección, servida por la caché.
Por qué resulta tan costoso para un proveedor de alojamiento
En un servidor compartido, un robot que se desboca en un sitio ralentiza a todos los demás. Los procesos PHP, las conexiones MySQL y la memoria son compartidos: unos pocos miles de páginas de facetas generadas en una hora bastan para alargar los tiempos de respuesta de decenas de sitios que no han pedido nada.
Tres factores agravan el caso de Amazonbot:
- Sin
Crawl-delay. El único ajuste estándar para pedir que vaya más despacio se ignora. Solo queda la prohibición pura y simple, parcial o total. - Solo páginas dinámicas. Un rastreador no descarga imágenes, CSS ni JavaScript; solo pide HTML, es decir, la parte más cara de producir.
- Ningún retorno. A diferencia de Googlebot o Bingbot, Amazonbot no aporta ningún visitante medible a una tienda en línea europea típica. El coste del servidor es real; el beneficio, hipotético.
Es este desequilibrio, más que el volumen bruto, lo que justifica tratarlo aparte de los buscadores clásicos.
Detectarlo en sus registros
Amazonbot se identifica honestamente con su user-agent: una simple búsqueda de la palabra Amazonbot en los registros de acceso basta para una primera medición. En un servidor Plesk, los registros están en /var/www/vhosts/system/<dominio>/logs/; si nginx hace de proxy delante de Apache, lea los archivos proxy_access*.
Los sitios más visitados por Amazonbot:
for d in /var/www/vhosts/system/*/; do
  n=$(cat "$d"logs/*access_ssl_log 2>/dev/null | grep -c Amazonbot)
  [ "$n" -gt 0 ] && echo "$n $(basename "$d")"
done | sort -rn | head
El ritmo hora a hora en un sitio, para detectar las oleadas:
grep Amazonbot /var/www/vhosts/system/example.com/logs/proxy_access_ssl_log \
  | awk '{print substr($4, 2, 14) "h"}' | uniq -c | tail -24
¿Robot auténtico o impostor?
Cualquiera puede escribir «Amazonbot» en un user-agent, y muchos robots maliciosos funcionan en servidores AWS alquilados, es decir, con IP que pertenecen a Amazon. Una IP «de Amazon» no prueba nada: el caso de Discourse de 2021 procedía de IP de EC2 y su autor concluyó que se trataba de un impostor.
Dos comprobaciones fiables:
- Comparar la IP con la lista publicada por Amazon.
- Hacer una resolución DNS inversa: el robot auténtico responde con un nombre en
crawl.amazonbot.amazon, que se confirma después con una resolución directa.
host <IP sospechosa>        # debe devolver ...crawl.amazonbot.amazon
host <nombre devuelto>      # debe devolver la misma IP
Esta distinción es importante: un impostor ignora el robots.txt, y solo un bloqueo en el servidor lo detendrá.
Las medidas, de la más suave a la más firme
1. El robots.txt, sitio por sitio
Es el método cortés, y Amazon se compromete a respetarlo para Amazonbot. Solo protege del robot auténtico y tarda hasta 24 horas en aplicarse.
Prohibir todo el sitio:
User-agent: Amazonbot
Disallow: /
O solo las facetas, dejando accesibles las fichas de producto:
User-agent: Amazonbot
Disallow: /*?*filter_
Disallow: /*?*pa_
Disallow: /*?*min_price=
Disallow: /*?*q=
Para rechazar el uso de sus textos en el entrenamiento sin bloquear el rastreo, Amazon reconoce también la etiqueta <meta name="robots" content="noarchive">.
2. ModSecurity, a nivel de servidor
El robots.txt solo vale para los robots que lo respetan, y se modifica sitio por sitio. El cortafuegos de aplicaciones ModSecurity actúa antes: rechaza una petición según su user-agent o la forma de su URL antes de que WordPress o PrestaShop entren en juego. Una petición bloqueada en esta fase no le cuesta casi nada al servidor, y los impostores que se hacen pasar por Amazonbot también quedan detenidos.
En un servidor Plesk, este ajuste puede aplicarse dominio por dominio, para proteger un sitio concreto sin tocar los demás, o de forma global para todos los sitios alojados. El nivel adecuado depende de sus sitios y de su tráfico: coméntelo con nuestro equipo técnico, que comprobará después en los registros que el ajuste produce el efecto esperado.
3. Cuidado con su código: nada de agujeros negros para los robots
El caso de JetBlog lo demuestra: el problema no venía solo del robot, sino de un módulo que fabricaba URL hasta el infinito. Para un rastreador, cada enlace nuevo es una página nueva que visitar. Un sitio que los genera sin fin se convierte en un agujero negro que lo absorbe, y cada pasada se paga en recursos del servidor.
Las fuentes de agujeros negros más habituales:
- los parámetros anticaché o con marca de tiempo añadidos a los enlaces, como el
nocachede la paginación AJAX de JetBlog; - los filtros por facetas de WooCommerce o PrestaShop, cuyas combinaciones se cuentan por miles;
- los calendarios y archivos que permiten avanzar mes a mes sin fin;
- las páginas de búsqueda interna accesibles mediante un enlace, incluso con una búsqueda vacía (
?s=).
Unos pocos reflejos suelen bastar: mirar en sus registros qué URL visitan realmente los robots, no exponer como enlace normal direcciones destinadas únicamente a AJAX, marcar esos enlaces con rel="nofollow", que Amazonbot respeta, y prohibir sus patrones en el robots.txt:
User-agent: *
Disallow: /*jet_blog_ajax=
Disallow: /*?*filter_
En nuestro caso, al tratarse del Amazonbot auténtico, la primera de estas líneas habría bastado para que abandonara la paginación de JetBlog, con el plazo de unas 24 horas anunciado por Amazon.
¿Bloquear o no?
Bloquear Amazonbot no tiene ningún efecto en el posicionamiento en Google o Bing, lo que lo convierte en una decisión de bajo riesgo para la mayoría de los sitios. Aun así, hay argumentos en ambos sentidos.
| Bloquear | Dejar pasar |
|---|---|
| Menor carga del servidor, sobre todo en las tiendas con facetas | Posible visibilidad en las respuestas de Alexa y de los servicios de IA de Amazon |
| Contenidos no reutilizados para entrenar modelos | Programa Amazon Content Partners: una pequeña bonificación en la comisión de afiliación y créditos de alojamiento para los sitios que lo autorizan |
| Ninguna pérdida de tráfico medible para un sitio europeo típico | El bloqueo por user-agent no detiene a los impostores, que exigen de todos modos otras defensas |
Para un sitio afiliado a Amazon o un medio que apuesta por la búsqueda por voz, un bloqueo parcial, limitado a las facetas y a las páginas de búsqueda, es un buen término medio. Para una tienda alojada en un servidor compartido, el bloqueo completo sigue siendo la opción más sencilla.
En resumen
Amazonbot no es un pirata: se anuncia, publica sus IP y respeta el robots.txt. Pero no sabe frenar, apunta a las páginas más caras y apenas aporta nada a los sitios que visita. Mida primero su peso en sus registros, compruebe que se trata realmente de él y elija después entre un robots.txt específico y un bloqueo en el servidor. Y elija lo que elija, proteja sus facetas: puede que el próximo robot no sea tan educado.
En HaiSoft vigilamos el tráfico de los sitios que alojamos y de los servidores que gestionamos. ¿Un robot sobrecarga su sitio o duda sobre la medida adecuada? Contacte con nuestro equipo técnico.
Fuentes
- Amazon Developer: About Amazonbot
- Amazon Developer: lista de IP de Amazonbot
- Xe Iaso: Amazon's AI crawler is making my git server unstable
- Ars Technica, vía Harvard TagTeam: Devs say AI crawlers dominate traffic
- Hypernode: How Amazon's web crawler could impact the performance of your online store
- Discourse Meta: Amazonbot abusive crawling
- SegmentFault: resumen de la entrada de git.gmem.ca